AI創薬の現在地と未来
日本の勝ち筋は「AI×品質保証×社会実装」
提供元:東洋リサーチアドバイス株式会社
人工知能(AI)の発展により、創薬分野においても個別化医療や希少疾患など、従来のアプローチでは困難であった疾患領域に対してAIの活用が活発化しています。世界的に数百兆円規模の投資が進む中、AI創薬の可能性について少し考えてみたいと思います。
新薬開発は成功確率3万分の1、かつ莫大な投資が必要
1つの医薬品が患者さんに届くまでには、約9〜17年の長い時間と、数百億円~数千億円規模の研究開発費を必要とします。また、化合物スクリーニング(探索段階)から承認までの成功確率は約1/31,000(0.0032%)とも言われ、年々低下しています。さらに、医薬品の特許が失効すれば後発医薬品が市場を侵食し、売上は減少します。そのため、新薬を開発する製薬企業は、特許存続期間中に、より多くの利益を上げて投資を回収しなければなりません。
AIの強みは「ターゲット探索力」
創薬の最上流では、疾患に関与するタンパク質を特定する「ターゲット同定」が行われます。次に、数十万〜数百万規模の化合物ライブラリーを用いて、標的タンパク質に対する結合力や機能を評価し、有望なヒット化合物を選抜します。さらに、選ばれた化合物を、薬効や安全性などを指標に医薬品として適切な性質を持つよう最適化することで医薬品は創出されます。
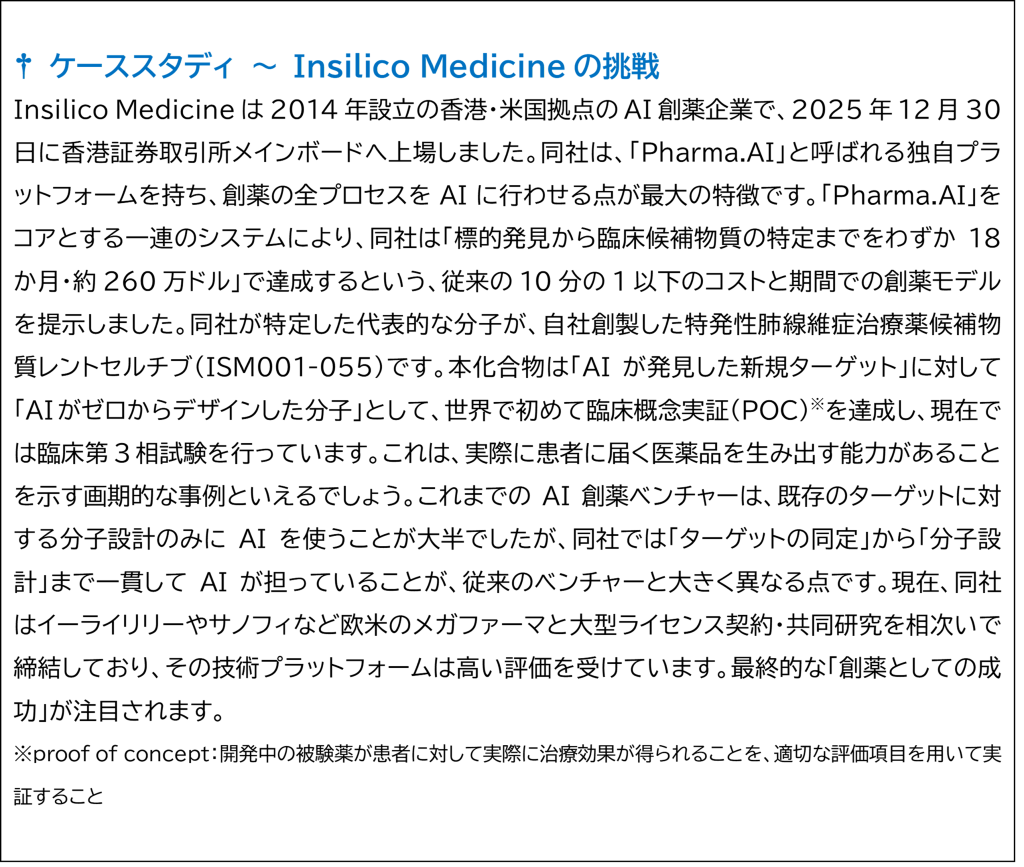
現在では、これら各ステップにAIを活用することで効率化や開発スピードの向上が図られています。これまで何年もかかっていたタンパク質の立体構造解析を瞬時にこなす「AlphaFold」の登場や、生成AIによる新規分子の自動設計、巨大な化合物ライブラリーから候補物質を探索する「インシリコスクリーニング」など、AIは驚異的なスピードで成果を上げています。AI創薬の最大の強みは、創薬プロセスの「入口」にあたるターゲット探索や化合物探索にあります。研究者が手作業で行っていた膨大な試験を代行し、成功確率の低そうな低品質な候補分子をあらかじめ排除することで、開発期間の劇的な短縮を可能にします。
対象領域はシンプルから複雑へ
低分子化合物は構造がシンプルかつロジカルであり、AIによる分子軌道計算と相性がよく、低分子化合物の開発ではAIが早くから導入されてきました。一方、複雑な構造をもつ抗体医薬のような高分子医薬の開発では、これまで研究者がトライ・アンド・エラーを繰り返して候補物質を探していました。しかし近年では、タンパク質のアミノ酸配列からその立体構造を高い精度で予測するAIプログラムが利用されるようになり、タンパク質の構造予測もある程度可能となっています。また、低分子と高分子の中間領域として注目されている中分子医薬にもAI技術の活用が拡大しています。今後、細胞・遺伝子医療や再生医療などを促進させるAI技術も登場するかもしれません。
AI活用の限界
しかし、ここで1つの重要な疑問が浮かび上がります。「計算上で完璧に見える分子を見つけること」は、果たして「安全かつ効果のある医薬品を作ること」と同じなのでしょうか?答えは『No』です。AIが得意とするのはあくまで「候補分子」を探し出すことであり、どれほど美しい分子構造を描けたとしても、それがそのまま医薬品になるとは限りません。計算機上のシミュレーションがいかに正確であっても、人間は遺伝的多様性、代謝経路、免疫応答、長期的毒性などが複雑に絡み合っています。デジタル空間の予測精度が向上しても、最終的には複雑な「ヒト生体内のリアルワールド」での臨床試験という大きなハードルを越えなければならないのです。
欲しいのは失敗データ
AIモデルが真に正確な予測を行うためには、質の高い膨大な訓練データが必要です。しかし、現在のAI創薬は根本的なデータインフラの不完全さという深刻な壁に直面しています。その元凶が「負のデータ(失敗データ)」の不足です。医学論文や公開データベースには、実験が成功した例ばかりが掲載される「Publication Bias(公表バイアス)」が存在し、ターゲットに結合しなかった化合物や、実験で意図通りに動かなかった「失敗例」は、論文に載ることなく研究者の実験ノートに埋もれてしまうのです。
成功例しか教えられていないAIモデルは、いわば「失敗パターンを知らないまま試験に臨む受験生」のようなものです。これでは予測のバイアスを回避できず、信頼性の高いモデルは作れません。さらに、近年では生成AIの普及に伴いデータ捏造や改ざんが容易になっており、不完全または改ざんされたデータでAIを訓練してしまうリスクも懸念されています。これらの「データの質の劣化懸念」を打破するために注目されているのが、予測・試験・最適化を24時間自動でループさせ、失敗データも含めて自律的に還元・蓄積する完全自動化ラボや、検索可能・アクセス可能・相互運用可能・再利用可能なFAIR※データ原則に基づくインフラ整備です。
※Findable(見つけられる)、Accessible(アクセスできる)、Interoperable(相互運用できる)、Reusable(再利用できる)の頭文字を取ったもので、これらの原則に従うことで、データの質と利用価値が向上します
イールームの法則とは
半導体の性能が指数関数的に向上する「ムーアの法則(Moore’s Law)」に対し、製薬業界には「イールームの法則(Eroom’s Law 「ムーア」の綴りを逆にしたもの)」と呼ばれる経験則が存在します。これは「新技術の導入にもかかわらず、一つの新薬の開発コストが約9年ごとに倍増する」という現実を指しています。
日本の勝ち筋は「AI×品質保証×社会実装」
なぜテクノロジーだけでは創薬の生産性を劇的に改善できないのでしょうか?それは、創薬の後半工程が依然としてきわめて「泥臭い」現場作業に依存しているからです。前半工程でAIが理想的な化学構造を設計しても、後半工程で実際に大量合成する医薬品開発製造受託機関(CDMO)への技術移管、適正製造規範(GMP)の遵守、スケールアップ製造時の品質同等性の担保、各国の規制当局への対応ができなければ、医薬品として患者さんの手に届くことはありません。
創薬は、計算科学を活用するDRY研究、細胞や微生物などを扱って生物学的な実験を行うWET研究、品質制御、製造、臨床、薬事規制が一体となっているのです。日本が米中の巨大なAIプラットフォームに対抗するための勝ち筋は、我が国が得意とする「製造技術・品質管理・規制対応」にAIを掛け合わせた「AI×品質保証×社会実装」の融合が鍵となるかもしれません。
(東洋証券)
1997年東洋証券に入社。支店営業、本社債券部を経て2007年5月から現職。国内医薬品市場の他、米国、欧州、中国の市場データ、新規モダリティのトレンド等の分析に注力。日本技術士会 修習技術者/生物工学部門(IPEJ, As.P.E.Jp/Biotechnology & Bioengineering)、日本バイオインフォマティクス学会(JSBi)認定技術者、国立研究開発法人産業技術総合研究所(AIST)生命情報科学技術者養成コース修了、知的財産管理技能士などの資格を保有。早稲田大学大学院修了(数理ファイナンス)。
関連リンク